
Route Flapping: Ursachen & Troubleshooting-Guide
Es ist 3:07 Uhr, das Monitoring färbt sich rot, und im Log rauschen die Meldungen durch: Route up, Route down, Route up, Route down. Route Flapping ist wohl eines der nervigsten und zugleich gefährlichsten Phänomene im Netzwerkbetrieb. Eine kurze Erklärung für alle, die gerade akut betroffen, und alle anderen natürlich auch, ist: Beim Route Flapping wird eine Route in schneller Folge angekündigt und wieder zurückgezogen, meist ausgelöst durch instabile Links, überlastete Router oder Fehlkonfigurationen. Die Folge sind Dauerstress für die Control Plane, Paketverlust und im Extremfall ein Dominoeffekt bis ins globale Internet. Wie Sie das Routenflattern erkennen, eindämmen und dauerhaft loswerden, lesen Sie in unserem Blogartikel.
Was ist Route Flapping? Eine Definition
Route Flapping, im Deutschen gelegentlich Routenflattern, im Englischen auch Route Oscillation oder schlicht Routing Flapping genannt, beschreibt das ständige Wechselspiel aus Route Advertisement und Route Withdrawal: Ein Router kündigt seinen Nachbarn eine Route an, zieht sie kurz darauf zurück, kündigt sie erneut an, und das im Sekunden- oder Minutentakt. Jede dieser Änderungen ist für sich genommen ein normaler Vorgang im dynamischen Routing. Zum Problem wird die schiere Frequenz.
Abgrenzung zum Link Flapping
Wichtig ist die Abgrenzung zum Link Flapping: Beim Link bzw. Interface Flapping wechselt ein physischer Port ständig zwischen up und down: ein Layer-1/2-Phänomen, das wir im Beitrag zum Port Flapping im Detail auseinandernehmen. Route Flapping dagegen spielt sich auf Layer 3 ab und betrifft die Routing-Information selbst. Ein Flapping Link ist oft der Auslöser, aber längst nicht der einzige. Und das macht die Sache tückisch: Während ein flappender Port lokal bleibt, verbreitet sich eine flappende Route wie ein Lauffeuer durchs Netz. Jeder Router, der das Update empfängt, muss reagieren, neu rechnen und die Änderung weiterreichen.
Wie Routing auf Änderungen reagiert
Um zu verstehen, warum Route Flapping so viel Schaden anrichtet, lohnt sich ein Blick auf die Mechanik dahinter. Dynamische Routing-Protokolle teilen sich in zwei Welten: Innerhalb eines Netzes arbeitet ein IGP (Interior Gateway Protocol) wie OSPF, EIGRP, IS-IS oder RIP; zwischen autonomen Systemen regiert das Border Gateway Protocol, kurz BGP. Beide Welten haben denselben Reflex: Ändert sich die Topologie, werden Updates verschickt, und jeder Router aktualisiert seine Routing Table. Genauer: die RIB (Routing Information Base), aus der die besten Pfade in die FIB (Forwarding Information Base) übernommen werden.
Eine Neuberechnung jagt die nächste
Die Zeit, bis alle Router wieder ein konsistentes Bild der Network Topology haben, ist die Convergence Time. Und da liegt das Problem: Flappt eine Route schneller, als das Netz konvergieren kann, jagt eine Neuberechnung die nächste. Instabilität pflanzt sich fort, vom betroffenen Router über seine Nachbarn bis zu Geräten, die mit der eigentlichen Störung gar nichts zu tun haben.
Die häufigsten Ursachen für Route Flapping
Instabile physische Verbindungen (Layer 1 & 2): Der Klassiker. Ein defektes Kabel, ein sterbender SFP, ein Wackelkontakt am Patchpanel oder ein MTU Mismatch zwischen zwei Enden, und schon geht das Interface im Takt auf und zu. Auch auf Layer 2 lauern Kandidaten: STP Flapping durch instabile Spanning-Tree-Topologien sorgt für ständige Umschaltungen, die sich nach oben ins Routing durchschlagen.
Hardware-Defekte und überlastete Router: Wenn die Control Plane am Limit läuft, erkennbar an dauerhaft hoher CPU Utilization, schafft der Router es nicht mehr, Keepalive Messages rechtzeitig zu beantworten. Nachbarn interpretieren das als Ausfall, reißen die Session ab, bauen sie neu auf: Flap.
Fehlkonfigurationen: Inkonsistente Timer (etwa eine zu knappe Hold-Time), fehlerhafte Prefix Lists oder eine Route Map, die Routen abwechselnd zulässt und filtert, gehören zu den häufigsten menschgemachten Ursachen für Routing Flapping.
Instabilitäten in Routing-Protokollen: Jedes Protokoll flappt auf seine Weise. OSPF Flapping zeigt sich in ständig neu aufgebauten Adjacencies, EIGRP Flapping gerne als Stuck-in-Active-Drama mit resettenden Nachbarschaften, und bei BGP kippen ganze Sessions samt aller darüber gelernten Präfixe. Auch RIP und IS-IS sind vor instabilen Nachbarschaften nicht gefeit.
Redundanz- und Failover-Probleme: Ausgerechnet die Mechanismen, die für Stabilität sorgen sollen, können Flapping produzieren, zum Beispiel wenn zwei Pfade mit identischen Metriken um den Vorzug ringen oder ein Failover-Mechanismus zu nervös hin- und herschaltet. Wie ein sauber geplantes redundantes Netzwerk aussieht, haben wir in einem Beitrag separat aufgeschrieben.
Auswirkungen von Route Flapping
Für IT-Entscheider die schlechte Nachricht zuerst: Route Flapping ist kein kosmetisches Problem, sondern frisst sich direkt in SLAs und Business-Kontinuität. Im Detail passiert Folgendes: Die permanenten Neuberechnungen treiben CPU- und Speicherlast auf den Routern nach oben. Die Konvergenz wird langsamer oder bleibt ganz aus, weil das Netz nie zur Ruhe kommt. Im Datenverkehr äußert sich das als Packet Loss. Der Paketverlust geht Hand in Hand mit erhöhter Latenz und Jitter, was Echtzeitanwendungen wie VoIP oder Videokonferenzen zuerst spüren.
Anwendungen und Services brechen ab
Anwendungen und Services brechen ab, TCP Session Resets inklusive. Ein gern übersehener Nebeneffekt: Auch Firewalls geraten ins Straucheln. Stateful-Inspection-Firewalls reagieren geradezu allergisch auf spontane Änderungen im Routing. Wandert der Traffic plötzlich über einen anderen Pfad, passt er nicht mehr zur bestehenden Session-Tabelle und wird schlicht nicht mehr bearbeitet. Schlimmer noch: Das plötzlich veränderte Verkehrsmuster kann False Positives auslösen, sodass die Firewall einen vermeintlichen Angriff erkennt und legitimen Traffic aktiv blockiert. Und im Worst Case entstehen Routing-Loops oder Black Holes: Traffic wird an einen Next-Hop geschickt, der unreachable ist, und verschwindet kommentarlos im Nirwana. Wie Sie solche Netzwerkfehler systematisch eingrenzen, zeigen wir Ihnen in unserem Grundlagen-Guide.
Route Flapping in BGP
Richtig ernst wird es beim BGP Route Flapping. Denn das Border Gateway Protocol ist das Rückgrat des Internets: BGP Peers tauschen über eine BGP Session Erreichbarkeitsinformationen aus, jede Route trägt ihren AS-Path (den Autonomous System Path) als Wegbeschreibung durch die autonomen Systeme, identifiziert über die ASN (Autonomous System Number). Kippt eine Session, angekündigt durch eine BGP Notification Message und sichtbar am wechselnden Peer State, verschwinden schlagartig alle darüber gelernten Präfixe und tauchen beim Neuaufbau wieder auf. Ein einziger instabiler BGP Neighbor kann so Tausende Routen gleichzeitig flappen lassen.
Unterschied zwischen iBGP und eBGP entscheidet über Schadensradius
Beim BGP Flapping entscheidet der Unterschied zwischen iBGP und eBGP über den Schadensradius: iBGP-Flapping bleibt im eigenen autonomen System und ärgert vor allem das interne Routing samt IGP-Interaktion. eBGP-Flapping dagegen wandert über den ISP (Internet Service Provider) oder Transit Provider hinaus in die große weite Welt. Ein hartnäckiger BGP Flap kann sich global fortpflanzen und die BGP Instability im gesamten Internet messbar erhöhen. Genau deshalb ist Prefix Flapping bei Providern so unbeliebt: Wer notorisch flappende Präfixe announced, riskiert, dass Gegenstellen die Notbremse ziehen. Ob deine Präfixe von außen stabil aussehen, verrät übrigens ein Blick in ein öffentliches BGP Looking Glass Tool.
Mechanismen zur Eindämmung
Gegen notorische Wackelkandidaten hat BGP einen eingebauten Erzieher: Route Dampening, auch BGP Flap Damping genannt, ursprünglich entwickelt als Antwort auf die wachsende BGP Instability der frühen Internet-Jahre, um BGP Route Flapping direkt an der Quelle auszubremsen. Das Prinzip ist ein Strafpunktesystem. Jeder Flap erhöht den Penalty Value der Route. Überschreitet die Penalty das Suppress Limit, wird die Route unterdrückt. Sie existiert zwar noch in der Dampening History, nimmt aber nicht mehr an der Routing-Entscheidung teil. Der Half-Life Timer lässt die Penalty kontinuierlich abschmelzen (typisch: Halbierung alle 15 Minuten), und erst wenn sie unter das Reuse Limit fällt, darf die Route wieder mitspielen.
Aggressiv konfiguriertes Dampening bestraft auch stabile Routen
Klingt elegant, hat aber Nebenwirkungen: Ein zu aggressiv konfiguriertes Dampening bestraft auch Routen, die nach einer kurzen Störung längst wieder stabil sind, und macht Ziele unerreichbar, die eigentlich erreichbar wären. Moderne Best Practices (unter anderem der RIPE-Community) empfehlen Route Dampening deshalb nur noch gezielt und mit moderaten Parametern statt flächendeckend. Der zweite große Hebel ist Route Aggregation: Wer viele spezifische Präfixe zu Summenrouten zusammenfasst, hält lokales Geflacker lokal. Die Aggregatsroute nach außen bleibt stabil, selbst wenn ein einzelnes Subnetz dahinter zappelt.
Schritt-für-Schritt-Anleitung zum Troubleshooting
- Schritt 1: Logs und Routing-Tabellen analysieren. Starten Sie mit den Fakten: show log, show ip route und bei BGP show ip bgp flap-statistics: Die Flap Statistics verraten Ihnen, welche Präfixe wie oft gekippt sind und wie hoch ihre Penalty steht.
- Schritt 2: Betroffene Route, Nachbarn oder Interfaces identifizieren. Grenzen Sie ein: Flappt ein einzelnes Präfix, alle Routen eines Nachbarn oder alles hinter einem Interface? show ip bgp neighbors, show ip ospf neighbor oder show ip eigrp neighbors zeigen Ihnen instabile Nachbarschaften auf einen Blick.
- Schritt 3: Physische Verbindung und Hardware prüfen. show interface liefert Input Errors, CRC-Fehler und Interface-Resets. Steigende Fehlerzähler oder ein Port im Dauerwechsel deuten auf Layer ½: Kabel, Optik, MTU Mismatch oder STP Flapping im darunterliegenden Switching.
- Schritt 4: Routing-Protokolle und Timer überprüfen. Passen Hold-Time und Keepalive auf beiden Seiten zusammen? Greifen Prefix List und Route Map so, wie sie sollen? Gerade nach Konfigurationsänderungen entstehen hier OSPF Flapping oder EIGRP Flapping durch schlicht inkonsistente Werte.
- Schritt 5: Stabilität testen und Monitoring auswerten. Nach dem Fix ist vor dem Beweis: Beobachten Sie Convergence Time, CPU-Last und Flap-Zähler über mehrere Stunden. Erst wenn die Kurven ruhig bleiben, ist das Problem wirklich gelöst, und nicht nur in der Mittagspause.
Best Practices zur Vermeidung von Route Flapping
Die beste Störung ist die, die gar nicht erst entsteht. Fünf Dinge, die sich in der Praxis bewährt haben:
- Eine hochverfügbare, redundante Netzwerktopologie mit sauber getrennten Pfaden. Link Aggregation fängt einzelne Leitungsausfälle ab, bevor daraus Routing-Ereignisse werden.
- Saubere Routing- und Peering-Konzepte mit Aggregation und klaren Filtergrenzen.
- Konsistente Timer- und Protokollkonfigurationen über alle Geräte hinweg, idealerweise automatisiert ausgerollt, auch in modernen SD-WAN-Umgebungen bleibt das Pflicht.
- Kontinuierliches Monitoring und Alerting, das Flaps erkennt, bevor Anwender sie melden: Ein Single Pane of Glass bündelt dafür Routing-, Interface- und Hardware-Metriken in einer Sicht.
- Automatisierte Incident Detection durch ein professionelles NOC: Bei nocware korrelieren wir Flap-Ereignisse, Interface-Zähler und Protokoll-Logs automatisch. So wird aus 47 Alarmen ein Ticket mit Ursache statt einer langen Nacht. Was wir dabei genau übernehmen, zeigen die Leistungen von nocware.
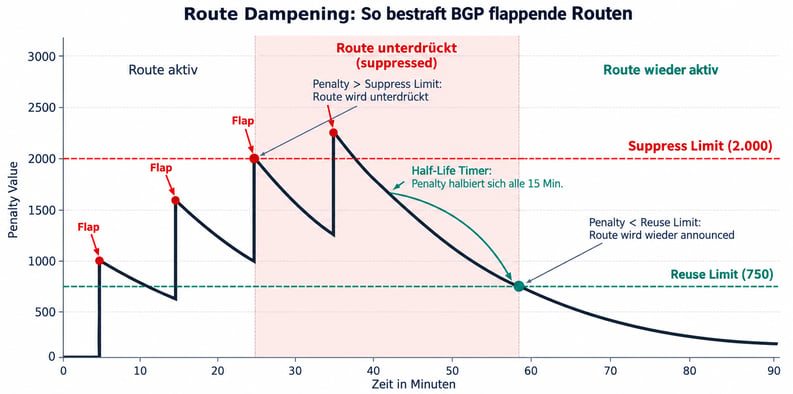
Route Dampening bestraft flappende Routen mit Penalty, Suppress Limit und Reuse Limit.
Route Flapping frühzeitig erkennen, dauerhaft vermeiden
Route Flapping ist selten ein Routing-Problem im engeren Sinn. Meistens ist es das Symptom einer tieferliegenden Ursache: ein instabiler Link, ein überlasteter Router, ein inkonsistenter Timer. Wer die Mechanik versteht (Updates, Konvergenz, Dampening), systematisch troubleshootet und auf sauberes Design plus lückenloses Monitoring setzt, bekommt das Flattern dauerhaft in den Griff. Und wer nachts lieber schläft, statt Flap Statistics zu lesen, holt sich Verstärkung: Unser NOC überwacht deine Infrastruktur rund um die Uhr und erkennt BGP Flapping und Route Oscillation, bevor daraus ein Ausfall wird. Am besten gleich Kontakt aufnehmen.